👤 管理人について
🌟 なぜ「Ewigkeit」なのか
このシステムの管理人のハンドルネームは Ewigkeit(エーヴィヒカイト) です。
Ewigkeit はドイツ語で「永遠」を意味する言葉ですが、
日本語の「永遠」や英語の「Eternal」とは、本質的に異なるニュアンスを持っています。
📖 それぞれの「永遠」
- 日本語「永遠」: 時間的な無限、終わりのない連続
- 英語「Eternal」: 不変性、変わらないもの
- ドイツ語「Ewigkeit」: 時間を超越した瞬間、永遠の今
ドイツの神秘主義では、Ewigkeitは「時間の外側にある瞬間」、
すなわち「今この瞬間が永遠である」という
より深い意味を持ちます。
それは単なる「長い時間」ではなく、
「完全性を持った、かけがえのない瞬間」を指します。
🌀 ニーチェの永劫回帰とロト6
ドイツの哲学者ニーチェは「永劫回帰(Ewige Wiederkunft)」という概念で、
同じ瞬間が永遠に繰り返されるという思想を説きました。
一見すると、ロト6の抽選は完全にランダムです。
しかし、2000回以上の過去データを統計的に分析すると、そこには
「繰り返される統計的パターン」が存在することが分かります。
例えば:
• 特定の数字ペアは、統計的に高頻度で同時出現する
• 奇数・偶数の比率は、長期的に一定の範囲に収束する
• 連番の出現率は、約55%という理論値どおりの確率的パターンを示す
これはまさに、ニーチェの言う「永劫回帰」の統計学的な表れと言えるでしょう。
📊 新概念:「統計的永劫回帰」
統計的永劫回帰(Statistical Eternal Recurrence)
「ロト6の抽選において、過去に観測された統計的パターン(=かけがえのない瞬間の集積)は、
未来において(異なる形で)永遠に繰り返される(回帰する)」
Ewigkeit(永遠の瞬間)
+
Loto6(抽選の積み重ね)
=
統計的永劫回帰
これは、「この瞬間を永遠のものとして大切に捉える」というEwigkeitの哲学と、
「AIによる統計分析」という技術を完璧に融合させた概念です。
🎯 このシステムに込めた想い
ロト6の1回1回の抽選は、まさにこの「Ewigkeit」です。
それぞれの抽選は二度と繰り返されない、かけがえのない瞬間。
過去のデータは「永遠に積み重なっていく歴史」であり、
その中から見出されるパターンは「時を超えて繰り返される真理」です。
LOTO6 AIの役割は、単なる「予測」ではありません。
「過去のデータ(=永遠の蓄積)から、
次に回帰してくる可能性が最も高いパターン(=Ewigkeit)を見つけ出すこと」
これが、このシステムの本質です。
単なる数字の予測ツールではなく、
統計学とプログラミング、そして哲学が交わる場所。
それが「LOTO6 AI - 永遠のロト6」です。
このシステムを通じて、皆様のロト6ライフが
より楽しく、より戦略的になることを願っています。
💻 プログラミングの力で統計解析を効率化
従来、手作業では何時間もかかる統計計算も、プログラミングによって数秒で完了できます。
【このシステムの特徴】
- 2000回以上の過去データを瞬時に分析
手作業なら数日かかる計算を、わずか数秒で完了
- 複雑な統計モデルを自動計算
カイ二乗検定、ベイズ推定、信頼区間など高度な統計手法を実装
- 人間の計算ミスを排除
プログラムによる正確無比な計算で、ヒューマンエラーをゼロに
- 膨大な組み合わせを高速処理
数百万通りの組み合わせを評価し、最適な候補を抽出
【計算速度の比較】
| 処理内容 |
手作業 |
本システム |
| 2000回分の出現頻度集計 |
約2週間 |
0.1秒 |
| 4要素パターン分析(全回) |
約1ヶ月 |
0.5秒 |
| 1000通りの組み合わせ評価 |
約3ヶ月 |
1秒 |
| バックテスト(100回分) |
約半年以上 |
10秒 |
💡 なぜ手作業ではこれほど時間がかかるのか?
2000回分のデータを1回ずつ確認・集計するだけで膨大な時間が必要です。
さらに、複雑な統計計算(カイ二乗検定、信頼区間など)を手計算で行うことは、
現実的にほぼ不可能です。プログラミングとコンピューターの計算力があって初めて、
このような高度な分析が実現できます。
【技術的な優位性】
過去データさえあれば、コンピューターの計算力で従来数ヶ月〜数年かかった分析を数秒で完了できます。
- 反復計算を高速実行(ループ処理の最適化)
- 並列処理による効率化
- データベース技術による高速検索
- アルゴリズムの最適化による計算量削減
✨ この高度な統計解析技術を、完全無料で皆様にご提供します ✨
プログラミングと統計学の力で、ロト6をもっと楽しく、もっと戦略的に。
📊 数学的背景
本システムで使用されている統計学的手法と数学的モデルについて詳しく解説します。
🔬 1. カイ二乗検定(Chi-squared Test)
出現番号の偏りを統計的に評価するために使用します。
観測度数と期待度数の差を検定し、$p$値が小さいほど偏りが大きいことを示します。
本システムでは、4要素分析(ひっぱり、連番、前後数字、下1桁ペア)に対してカイ二乗検定を適用しています。
期待度数が5未満のカテゴリは隣接カテゴリと統合(v7.52変更)することで、
Cochranの経験則を満たしつつ、カテゴリ数変動によるp値の過敏な揺れを抑制しています。
p値は $1 - F(\chi^2; \text{df})$ の正確な上側確率として算出し(v7.50以降)、
本システムでは「直近データと補集合の同質性」から算出するdf標準化χ²統計量 T=(χ²−df)/√(2df) を「モデル安定性」の指標として使用します(v7.64。Cramér's Vとp値は参考表示)
(§7参照。通常の統計学における有意差判定とは異なる用法です)。
📊 2. 出現頻度分析(Frequency Analysis)
各番号の過去N回における出現回数を集計し、出現パターンを分析します。
頻度スコア = 50 + 15Z を 0〜100 にクリップ(v7.63)
Z = (出現回数 − nμ)/√(np(1−p))、p = 6/43(二項分布の帰無平均・帰無SDで標準化)
→ 偏りがなければスコアは50付近に自己収縮し、実際の偏りがあるときだけ広がります
期待出現率 = 6/43 ≈ 13.95%
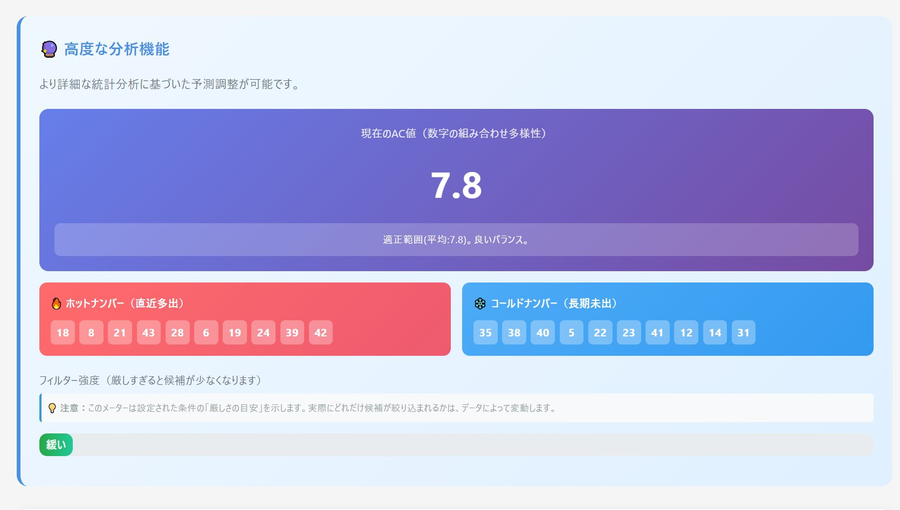
ホット/コールド番号: 直近20回の出現回数の上位/下位10個(実装準拠)
※直近20回の期待出現回数は 20×6/43 ≈ 2.79回(SD≈1.55)であり、
短期の順位差の大部分は偶然変動の範囲に収まります
統計的には、十分な試行回数があれば全番号の出現頻度は均等に収束しますが、
短期的にはゆらぎが発生します。このゆらぎに注目することで、
一時的なトレンドを捉えようとするのが頻度分析の考え方です。
📈 3. トレンド分析(Trend Analysis)
時間加重による最近の傾向を重視した分析を行います。
トレンドスコア = Σ (出現フラグ × 時間減衰係数)
時間減衰係数 = e^(-λt)
λ: 減衰率パラメータ(通常0.05-0.1)
t: 経過回数(0が最新、大きいほど古い)
最近の抽選ほど高い重みを与えることで、現在進行中のトレンドを捉えます。
指数関数的な減衰により、古いデータの影響を自然に低減させます。
🔗 4. ペア分析(Pair Analysis)
各番号が他の番号と同時出現しやすいかどうかを分析します。
本システムでは、各番号について「共起した相手番号との平均共起回数」を計算し、
頻度成分を回帰で除去した残差(ペア集中度)を標準化して 0-100 のスコアに変換します(v7.63)。
【実装アルゴリズム】
Step 1: 番号ペア(i, j)が同一抽選回で出現した回数をすべて集計
Step 2: 番号iについて「共起回数の上位3相手との平均」を算出(v7.65: 全42相手の平均では集中したペア構造が希釈され検出力が落ちるため)
→ rawScore[i] = mean(pairCount[i][j]) for j ≠ i
Step 3: rawScore を出現回数にOLS回帰し、残差を取得(v7.63)
→ 旧方式は頻度と相関 r≈0.9 の実質同一因子で、頻度分析との二重計上だった。
残差化により頻度と直交な「ペア集中の成分」だけを残す
Step 4: 残差を経験SDでZ標準化し、pairScore[i] = 50 + 15Z を 0〜100 にクリップ
【参考: 理論的ペア出現率】
任意の2番号が同時出現する理論確率
= C(41,4)/C(43,6) = 101,270/6,096,454 ≈ 1.66%
理論上、各番号の出現は独立事象ですが、実測データでは番号ごとに「よく他と一緒に出る番号」と
「あまり他と一緒に出ない番号」の差が観測されます。これは有限サンプルのゆらぎである可能性が高く、
必ずしも物理的な偏りを示すものではありません。本スコアはその観測パターンを
候補評価の一因子として取り入れるためのものです。
※注意: 過去データの「よく共起する」番号が未来でも共起する保証はありません。
サンプル数が増えれば理論的には各ペアの共起率は1.66%付近に収束します。
⏱️ 5. ギャップ分析(Gap Analysis)
各番号が出現してからの経過回数を分析し、「久しく出ていない番号」を可視化するスコアです。
現在のギャップ = 最新回 - 最終出現回
帰無平均 μG = (1−p)/p ≈ 6.17、帰無SD σG = √(1−p)/p ≈ 6.65(p = 6/43)
ギャップスコア = 50 + 15 × (現在のギャップ − μG)/σG を 0〜100 にクリップ(v7.63)
※ 旧方式の分母「自身の観測頻度」は、同じ不出現期間でも番号の頻度によってスコアが
変わる頻度情報の混入を招いていた。全番号共通の理論値(後方再帰時間の幾何分布)に変更
⚠️ 統計的な注意事項(ガンブラーの誤謬について)
ロト6の各抽選は独立事象であり、「久しく出ていない数字ほど次に出やすい」
というのは統計学上は誤りです。これは「ガンブラーの誤謬
(Gambler's Fallacy)」として知られています。
各抽選で各数字が出る確率は常に 6/43 ≈ 13.95% であり、過去の出現履歴は次回に影響しません。
本ギャップスコアは、統計的に正しい予測を提供するものではなく、
「久しく出ていない数字」を好む心理的選好をもつユーザーのための補助指標として提供しています。
本システムではギャップスコアの重みはデフォルト15%です。
他の分析手法(頻度、4要素、ペア、トレンド、バランス)と合わせた総合評価を行いますが、
重みをゼロにすれば、この指標を使わずに予測を生成することも可能です。
⚖️ 6. バランス分析(Balance Analysis)
直近20回の出現をゾーン(1-14 / 15-28 / 29-43)と偶奇に分けて集計し、
「いま不足しているクラスに属する番号」を高く評価する、個々の番号単位のスコアです
(v7.64: 本文を実装に一致させました。合計値・偶奇比・連番などの組合せ単位の
条件は本スコアではなく「フィルター機能」が担当します)。
ゾーン不足度 Z₁ = (期待ゾーン出現数 − 実測) / √(slots · q(1−q) · 37/42)
偶奇不足度 Z₂ = (期待偶奇出現数 − 実測) / √(slots · q(1−q) · 37/42)
バランススコア = 50 + 15 × (Z₁ + Z₂)/√2 を 0〜100 にクリップ
※ slots = 直近20回 × 6個 = 120、q は各クラスの構成比(v7.63で連続量化)
※ 抽選内は非復元抽出のため、分散に有限母集団補正 (43−6)/(43−1) = 37/42 が掛かります(v7.64)
※ 参考: 組合せ合計値の理論分布は μ = 132, σ ≈ 28.5(μ±σ = [103,161] に約68%)
⚠️ 統計的な注意事項(ギャップ分析と同種の注意)
「不足しているクラスがそろそろ補充される」という期待は、§5ギャップ分析で警告している
ガンブラーの誤謬と構造的に同一です。各抽選は独立事象であり、
直近のゾーン・偶奇の偏りは次回の出現確率を一切変えません。
本スコアは偏りがなければ全番号が50点付近に収縮するZ標準化設計であり、
直近の偏りを好みに応じて反映するための補助指標としてご利用ください。
📊 ハイブリッドスコアリング手法
本システムでは、上記6つの分析手法を組み合わせた「ハイブリッドスコアリング」を採用しています。
各手法のスコアを重み付けして合算することで、多角的な視点からの予測を実現しています。
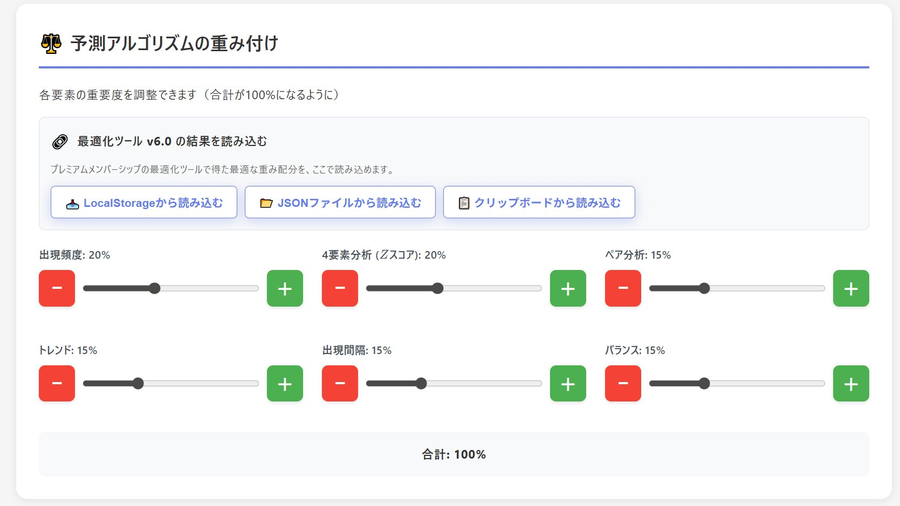
基本成分 P = (w₁×頻度 + w₃×ペア + w₄×トレンド + w₅×ギャップ + w₆×バランス) / (w₁+w₃+w₄+w₅+w₆) を6数字で平均
総合スコア = 50 + 15 × (w_B×Z(P) + w₂/100×Z(要素)) / √(w_B² + (w₂/100)²) (v7.65: 成分別帰無SD標準化)
制約条件: Σwᵢ = 100%, wᵢ ≥ 0
デフォルト重み:
頻度: 20%, 要素: 20%, ペア: 15%
トレンド: 15%, ギャップ: 15%, バランス: 15%
🎯 7. $Z$スコアによる「典型性」評価
生成された予測候補の4要素パターン(ひっぱり、連番、前後数字、下1桁ペア)が、
過去の長期的な出現パターンにどれだけ「典型的」かを$Z$スコアで評価します。
💡 本システムのスコアの性質について
このスコアは「過去の典型的な出現パターンに類似した候補を高く評価する」
という選好を表現しています。いわゆる回帰効果を反映したものであり、
「外れ値的な組み合わせを避ける」方向に働きます。
統計学的に「このスコアが高い候補の出現確率が高い」と証明されているわけではありません。
ロト6の抽選は本質的に独立事象であり、すべての組み合わせは理論上 1/6,096,454 で等しく出現します。
本スコアは、統計的に妥当な「典型的」パターンを選好するための補助指標として
ご利用ください。
非典型モード(v7.63追加・v7.64再設計)。パリミュチュエル方式では当選確率は
どの組合せでも不変ですが、人気のあるパターンは当せん時に多人数で分配するため、
期待配当の観点では人気の薄いパターンの方が理論的に有利です
(「重要な注意事項」の人気薄戦略に対応)。上級者向けに、ブラウザのコンソールで
AppState.typicalityMode = 'atypical' を実行すると、4要素枠の評価が
分配回避スコア = 50.41 + 8×(4.33 − 31以下の個数) − 12×[準等間隔 gapSD<1.5] − 15×[4連番以上] − 10×[同下1桁4個以上]
に切り替わります(既定は 'typical'=従来挙動)。
v7.65では、実物のマークシート格子配置が検証できなかったため7列想定の行分散項を撤去し
(番号43が単独行となる+8.2点の人為的優遇が生じていました)、発火率0.003%で実質デッドだった
完全等間隔ペナルティを、発火率を実測校正したレイアウト非依存の規則性指標
(準等間隔2.7%・4連番0.46%・同下1桁0.26%)に置き換えました。実測により、購買人気を実際に
偏らせる軸は誕生日レンジ(1〜31)への集中とマークシートの幾何的規則性であり、
4要素はこれらとほぼ直交している(Z符号反転では期待配当のレバーが動かない)ことが
確認されたため、v7.64で人気軸を直接扱う方式に変更しました。
なお本機構は加重平均の配分機構であるため、4要素間の安定性の実測差
(T統計量方式では平均0.23程度・v7.65更新)が最終スコアへ与える影響は0.1点未満と小さく、実質的には
参考的機構であることを明示します(削除せず残しているのは、
実データに真の偏りが生じた場合の自動減衰装置としての保険的役割のためです)。
v7.61よりモデル安定性の指標は$p$値から効果量(Cramér's V)に変更し、
v7.63でdfバイアス補正、v7.64で切断バイアスの除去(df標準化 $T$ 統計量)を適用しました。
$p$値の大きさは「差の証拠がない」ことしか意味せず、サンプル数が少ないほど大きく出る性質があるためです。
効果量は乖離の大きさそのものを測るため、安定性の指標として統計学的に一貫します。
あわせて検定の対象を「直近 vs 全体(直近を含む)」から「直近 vs 補集合」に変更し、標本の独立性を回復しています。
📉 8. 信頼区間の計算(バックテスト用)
バックテスト結果の統計的信頼性を評価します。
Wilson Score 信頼区間(95%):
p̂ = 成功回数 / 試行回数
z = 1.96(95%信頼区間の場合)
n = 試行回数
調整後推定値 = (p̂ + z²/2n) / (1 + z²/n)
誤差範囲 = z × √[(p̂(1-p̂)/n + z²/4n²)] / (1 + z²/n)
下限 = 調整後推定値 - 誤差範囲
上限 = 調整後推定値 + 誤差範囲
Wilson Score法は、サンプル数が少ない場合や確率が0%または100%に近い場合でも
安定した信頼区間を提供します。信頼区間が狭いほど、推定精度が高いことを示します。
💡 統計的有意性について
本システムの分析は、統計的な傾向とパターンに基づいていますが、
以下の点に注意が必要です:
- 過去のパターンが将来も続くとは限りません(過学習のリスク)
- 短期的なトレンドは偶然のゆらぎの可能性があります
- 十分な母集団(数百〜数千回の抽選データ)が必要です
- p値 < 0.05 でも約5%の確率で偽陽性が発生します
⚠️ 重要な注意事項
これらの統計分析は、過去のデータに基づくパターン認識であり、
将来の当選番号を保証するものではありません。
理論的背景:
ロト6の抽選は各回が独立事象であり、各組み合わせの当選確率は理論上
1/C(43,6) = 1/6,096,454 で等しくなります。
統計分析は、完全にランダムではない可能性(機械的バイアス、
球の摩耗など)や、心理的戦略(人気薄の番号を選ぶ)に
利用価値がありますが、当選確率を根本的に向上させるものではありません。
本システムは教育・研究目的での統計分析ツールとして
ご利用ください。過度な期待や依存は避け、責任ある範囲でのご利用をお願いします。
🤝 9. 集合知の原理(Collective Intelligence)
複数の分析手法を統合することで、単一手法より多角的な予測を実現します。
本セクションでは、本システムで実装済みの手法と、
理論的参考(将来拡張候補)を分けて説明します。
✅ アンサンブル学習(実装済み)
6つの分析モデルを重み付け線形和で統合して最終予測を生成しています:
最終スコア = 50 + 15 × (wB·ZB + wE·ZE) / √(wB² + wE²) (v7.65)
ZB: 5指標の重み付き平均を6数字で均した「基本成分」を、その帰無平均・帰無SDでZ化した値
ZE: 4要素枠(典型モード)または分配回避スコア(非典型モード)を同様にZ化した値
wB = 5指標の重み合計/100、wE = 要素の重み/100
【v7.65: なぜ単純加算をやめたか】基本成分は「番号単位スコアの6個平均」のため
帰無SDが約√6分の1に縮む一方、4要素枠は組合せ単位でSDが縮まない。このため旧方式
(Σw×score)では名目80:20の重みが実効50:50になっていた(分散分解の実測)。
成分を各々の帰無SDでZ化してから合成することで、重みが帰無SD単位の影響力比に一致する。
【使用しているモデル(デフォルト重み)】
- 頻度分析モデル(w₁ = 20%)
- 4要素分析モデル(w₂ = 20%)
- ペア分析モデル(w₃ = 15%)
- トレンド分析モデル(w₄ = 15%)
- ギャップ分析モデル(w₅ = 15%)
- バランス分析モデル(w₆ = 15%)
単一のモデルではなく、異なる視点を持つ複数のモデルを組み合わせる設計です。
ただし各モデルは完全には独立でないことを開示します:頻度とペアは v7.62 まで
相関 r≈0.9 の実質同一因子だったため、v7.63 でペアから頻度成分を回帰除去し
直交化しました。トレンドとギャップは定義上(直近重視 vs 長期未出現重視)
逆向きの対(相関 r≈−0.7)であり、両者の重みを同時に上げると互いに打ち消し
合います。さらに頻度とトレンドは同じ「出現強度」を異なる時間窓で測るため正の相関
(公正データ実測で r ≈ 0.4、偏りがあると r ≈ 0.7 まで上昇)を持ち、
頻度・トレンド・ギャップの3者で一つの出現強度クラスタを形成します
(既定重みの50% = 20+15+15 がこのクラスタに集中)。実効的な独立因子は、
相関行列の固有値エントロピー換算で5指標中約4.2本です(v7.63実測)。
重みはユーザーが自由に調整でき、有料版の「最適化ツール」では
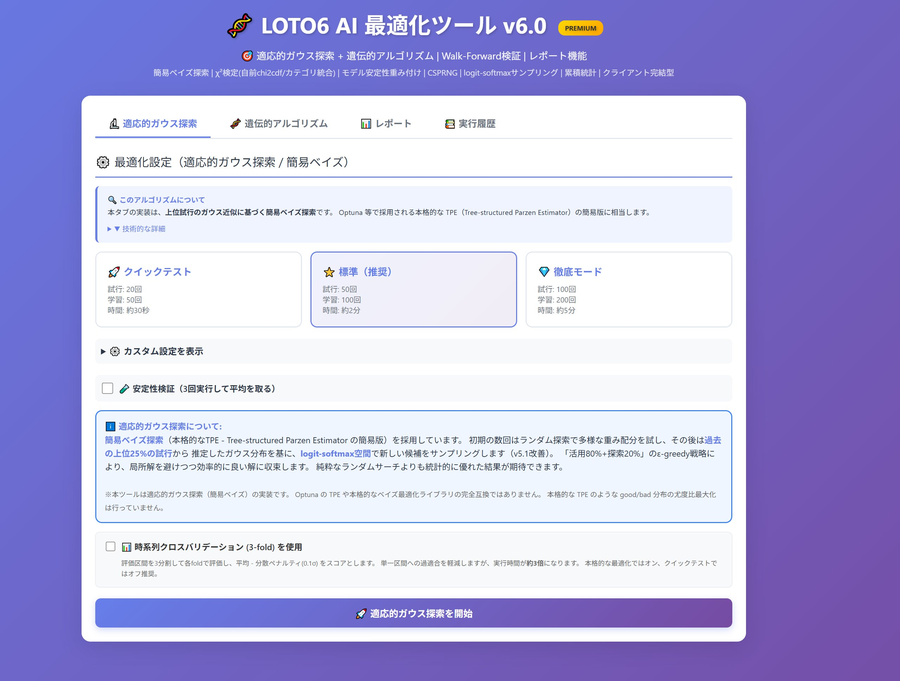
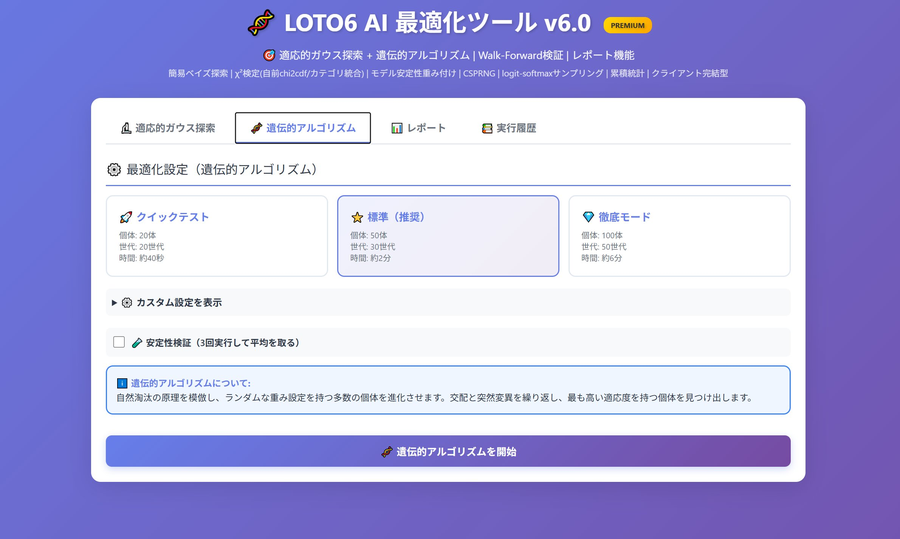
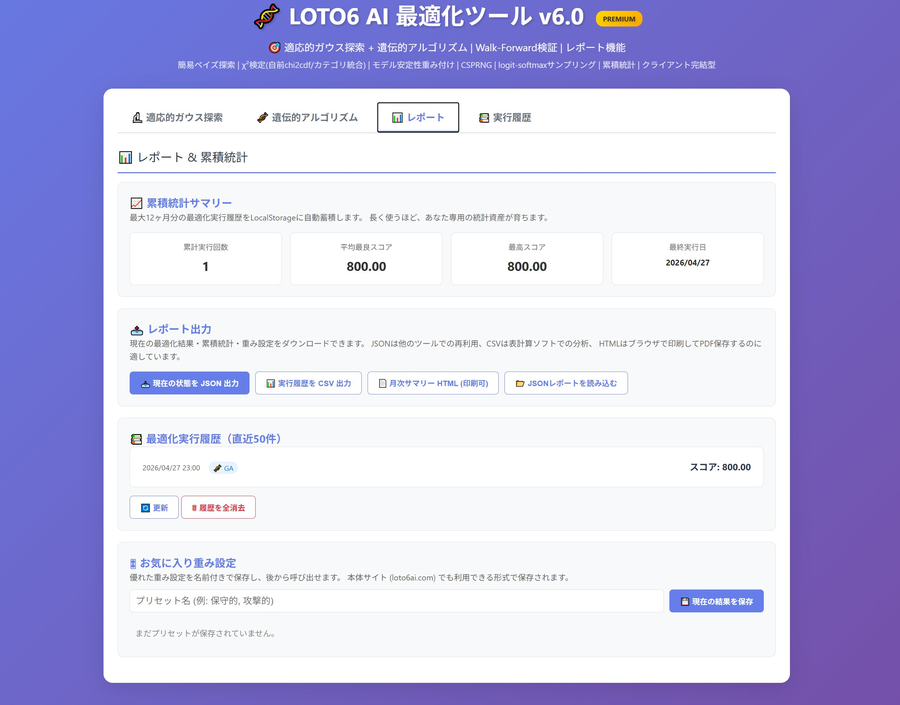
バックテストに基づいて重みを自動探索できます。
✅ 信頼区間による不確実性の定量化(実装済み)
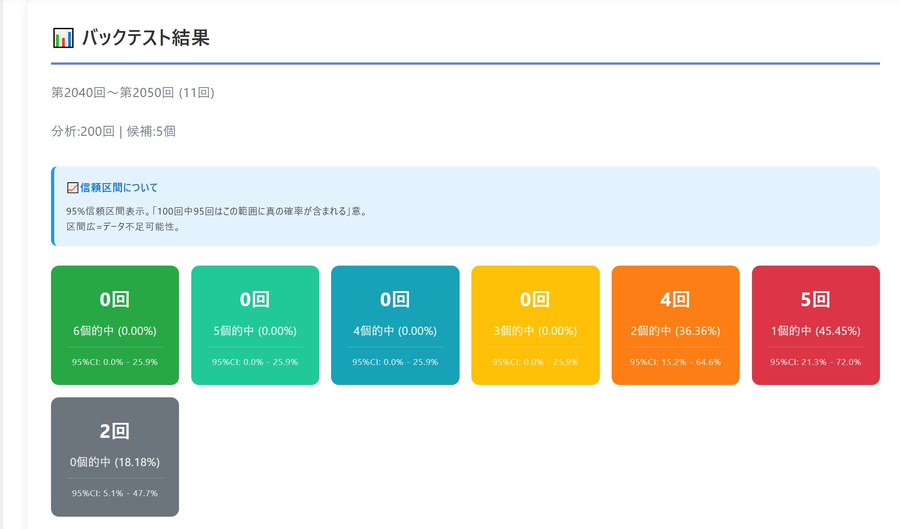
バックテスト結果にWilson Score信頼区間を適用し、予測精度の不確実性を定量化しています:
Wilson Score 95%信頼区間:
CIcenter = (p̂ + z²/2n) / (1 + z²/n)
CImargin = z √[p̂(1-p̂)/n + z²/4n²] / (1 + z²/n)
p̂: 的中率(成功数 / 試行数)
z: 信頼水準係数(95%なら z = 1.96)
n: サンプル数(バックテスト回数)
【解釈例】
3個的中率: 15% ± 3% (95% CI: [12%, 18%])
→ 同じ手順で区間を作り続ければ、100回中95回は区間が真の的中率を含む(区間が動く量であり、真の値は固定)
通常の正規近似よりサンプル数が少ない場合・的中率が0%や100%に近い場合でも
安定した信頼区間を提供するWilson Score法を採用しています。
バックテスト機能でこの信頼区間が表示されます。
🔮 ベイズ推定(理論的背景・将来拡張候補)
以下はアンサンブル学習の理論的背景にある考え方で、
現行システムでは直接には実装されていませんが、
将来的な改良の方向性として参考情報として記載します。
P(H|D) = [P(D|H) × P(H)] / P(D)
P(H|D): 事後確率(データを見た後の確率)
P(D|H): 尤度(仮説が正しいときデータが得られる確率)
P(H): 事前確率(過去の統計から得られた確率)
P(D): 正規化定数
将来的に、各分析モデルのスコアを事後確率として動的に更新する機構を
追加することで、より適応的なシステムに発展させる余地があります。
🔮 モデル多様性スコア(理論的参考)
集合知が機能するには、統合するモデル間に独立性があることが望ましいとされます。
以下は多様性を定量化する理論的な指標で、参考情報として記載します(現行では直接計算していません):
多様性スコア = 1 - (モデル間の相関係数の平均)
相関係数 r = Cov(X, Y) / (σX × σY)
r → 0 に近いほど、モデルは独立
本システムで6つの分析手法を採用している理由は、多様な視点から予測する
ことで集合知の効果を高めるためですが、各モデルの相関を動的に測定する
機能は現在未実装です。
🧠 なぜ複数のモデルを組み合わせるのか
- 誤差の相殺効果: 各モデルの誤差は異なる方向を向いているため、平均化すると相殺されやすい
- ロバスト性の向上: 一部のモデルがうまく機能しない場面でも、他のモデルがカバーする
- 過学習の軽減: 単一モデルの過度な特化を防ぎ、汎化性能を保つ
- 多角的な視点: 短期トレンド、長期パターン、構造的特徴など、異なる側面を捉える
「三人寄れば文殊の知恵」という諺が示すように、
複数の視点を統合することで、単独では見えなかった洞察が得られます。
これが本システムのアンサンブル学習アプローチの核心です。
※重要な免責:複数モデルの統合は予測の信頼性向上に役立ちますが、
ロト6は各抽選が独立事象であり、どのような統計手法を用いても
個別の抽選結果を決定論的に予測することは理論上不可能です。
本システムは統計的パターンの可視化と学習を目的としています。